

Авторы

Защиту информационных систем в современной организации обеспечивает целый комплекс технологий, которые генерируют тысячи оповещений безопасности каждый день. Если взглянуть на массив этих оповещений, можно увидеть, что значительная часть из них — ложноположительные срабатывания. Такие оповещения хочется отфильтровывать автоматически, чтобы аналитик сосредоточился на тех, которые могут свидетельствовать о реальном инциденте. Однако само по себе написание фильтров — тоже трудоемкая задача. Чтобы создать корректный фильтр, аналитику нужно:
- изучить логи;
- идентифицировать источник активности;
- определить границы фильтрации;
- выбрать критерии фильтрации;
- написать правило;
- проверить его устойчивость.
В этой статье разберем, как можно автоматизировать непосредственно создание фильтров, чтобы снизить нагрузку на аналитика.
Критерии валидности фильтров
В контексте оповещений безопасности фильтр — это некая комбинация значений полей события, которая указывает на то, что детект ложноположительный и не требует внимания аналитика. Можно сгенерировать фильтры для любых комбинаций полей события, однако далеко не все комбинации позволяют получить валидный фильтр. Поэтому нужно определить некие критерии валидности, то есть того, что конкретный фильтр действительно отсеивает информационный шум и не блокирует полезные оповещения.
Как правило, детектирующие правила в системах безопасности содержат набор условий, каждое из которых может сгенерировать оповещение. Конкретное событие триггерит какой-то фрагмент детектирующего правила. Множество событий, на которые реагирует этот конкретный фрагмент, мы назовем контекстом. Хороший фильтр должен по возможности покрывать контекст целиком и при этом не выходить за его пределы. Слишком широкие и слишком узкие фильтры будут бесполезными. Так, если сделать фильтр по PowerShell, он отбракует слишком много событий, в том числе те, на которые аналитику стоит обратить внимание. При этом большинство отфильтрованных событий не будут иметь отношения к конкретному детектирующему правилу. А фильтр по конкретному ID, напротив, покроет только одно событие, которое может в будущем никогда не возникнуть повторно.
Проблемы, возникающие при генерации фильтров
При создании фильтров мы можем столкнуться с рядом проблем. Во-первых, часто события содержат избыточное количество полей (в среднем около 400), большинство из которых не нужно для фильтрации. При этом генерация комбинаций этих полей и их ранжирование — это довольно трудоемкая задача. Поэтому первым делом следует отбросить не интересующие нас поля и оставить только те, которые есть смысл использовать в фильтре. Так, из 400 полей в событии для фильтрации может быть достаточно четырех.
Еще одна проблема — нормализация строк. Значения полей — например, путь к одному и тому же приложению в разных системах — могут различаться в зависимости от настроек конкретной системы, имен пользовательских папок и т. д. Чтобы фильтр учитывал все эти вариации, необходимо нормализовать строки. В частности, для путей к файлам можно заменить букву диска и пользовательские папки на стандартизированные переменные окружения и приводить все пути к единому регистру.
Наконец, если фильтр полностью повторяет запрос детектирующего правила, он фактически отключает это правило. Решить эту проблему можно, устранив из фильтра те поля события, которые используются в детектирующем правиле. Например, если правило срабатывает на путь к файлу, можно отфильтровать нежелательные оповещения двумя способами.
- Использовать в фильтре поля, отличные от пути к файлу.
- Использовать в фильтре фрагмент пути к файлу, который не задействован в правиле. Так, для правила
file_path: ".../something.exe"можно настроить фильтр, который исключает события, содержащие в пути к файлу директориюuser/unique_files/.
Фильтрация оповещений безопасности при помощи алгоритма
С учетом озвученных проблем автоматическая генерация фильтров для оповещений безопасности должна состоять из следующих шагов.
- Аналитик получает оповещение безопасности, которое оценивает как ложноположительное, и обращается к генератору фильтров.
- Генератор берет событие из оповещения, состоящее из 400 полей, и правило, которое сработало на это событие, — и определяет контекст.
- Генератор отбирает поля, которые релевантны для фильтра.
- Генератор нормализует строки.
- Генератор формирует различные комбинации отобранных полей. Для этого мы использовали алгоритм FP-Growth (frequent pattern growth) на определенном ранее контексте. FP-Growth строит на массиве данных (в нашем случае — на контексте) дерево часто встречающихся элементов (полей), отбрасывая недостаточно частые. Это позволяет сократить количество комбинаций, которые необходимо перебрать, и таким образом сэкономить затраты на подбор наиболее релевантных.
- Генератор ранжирует полученные комбинации и отдает аналитику топ-3 на выбор.
Например, рассмотрим событие, описанное следующим JSON:
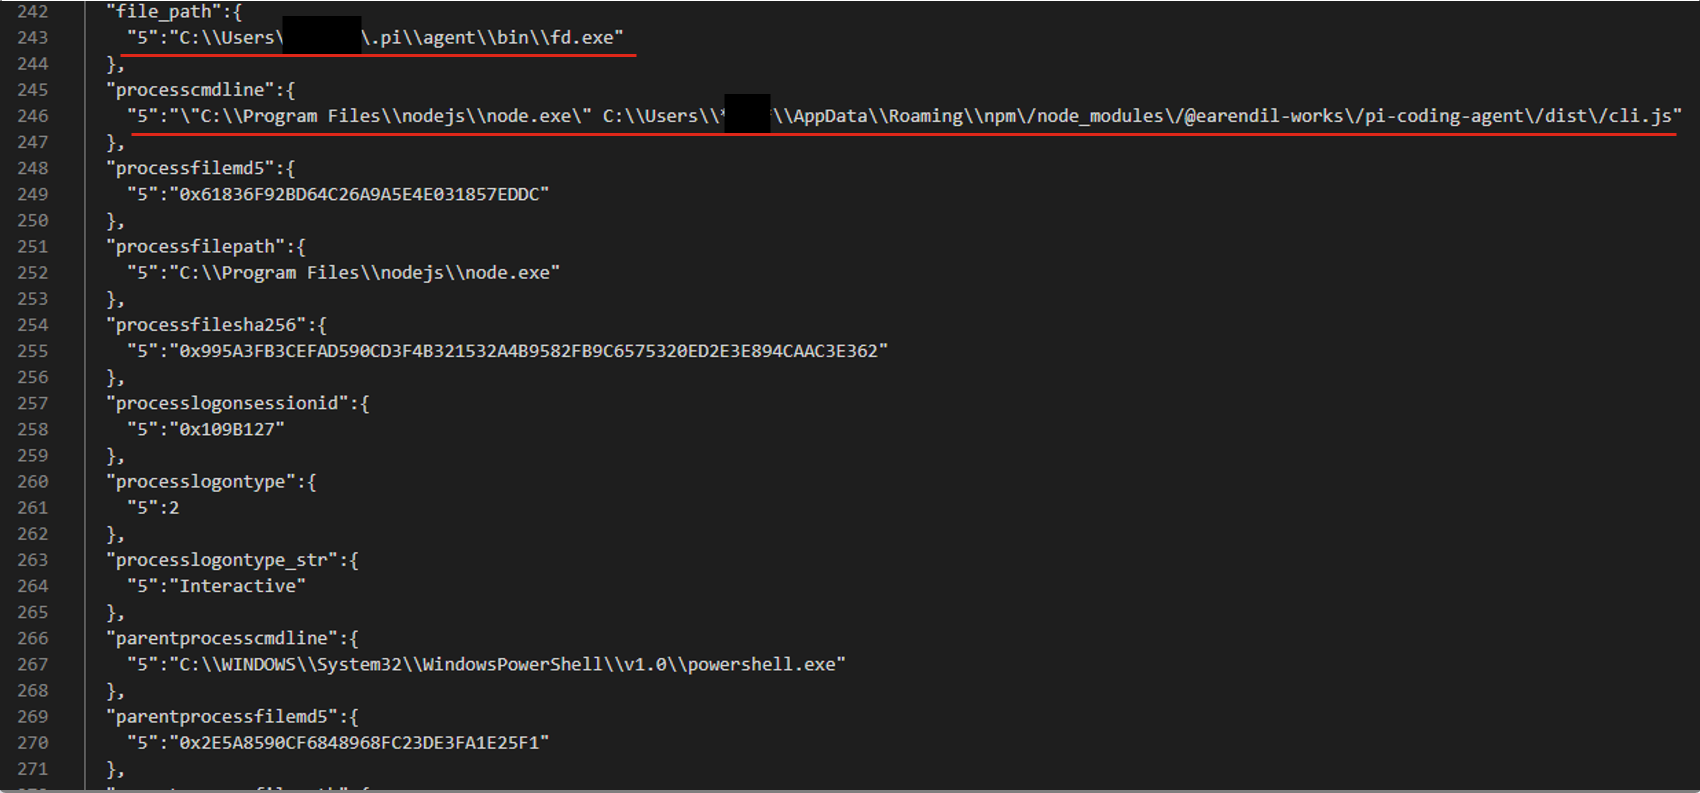
По результатам генерации и ранжирования комбинаций мы получили три фильтра, основанные на путях к файлам:
-
1processcmdline:("nodejs\\node.exe" AND "*****\\appdata\\roaming\\npm\/node_modules\/pi-coding-agent\/dist\/cli.js")
-
1file_path:"*****/.pi\\agent\\bin\\fd.exe"
-
1processcmdline: "programfiles\\nodejs\\node.exe"
Последний фильтр оказался слишком широким, однако два других аналитик отметил как валидные.
Преимущества и недостатки описанного подхода к генерации фильтров
У алгоритмического подхода к генерации фильтров есть ряд плюсов. Во-первых, он достаточно прост и детерминирован, то есть результат для конкретного оповещения будет воспроизводиться при каждой генерации. Во-вторых, он интерпретируем, то есть позволяет нам понять, почему конкретная комбинация при ранжировании оказалась в верхней части списка, а конкретное поле вообще не вошло в перечень полей-кандидатов. В-третьих, этапы этого процесса не зависят друг от друга, соответственно, можно улучшать и настраивать отдельные шаги, не опасаясь, что это сломает алгоритм в другом месте. Наконец, в нем нет внешних зависимостей и моделей, поэтому его легко развернуть в любом контуре на стороне клиента.
Однако есть и недостатки. В первую очередь это зависимость от контекста. Если контекста по какой-то причине нет — например, это первое срабатывание правила на событие — то создать фильтр не получится. Вторая проблема — нормализация строк: велика вероятность столкнуться с нетипичными случаями, которые не охвачены правилами нормализации, а зачастую и не поддаются корректному описанию, поскольку противоречат друг другу.
Решить эти проблемы можно с помощью больших языковых моделей (LLM). Если фильтры генерирует LLM, нет необходимости в контексте, поскольку LLM не перебирает и не ранжирует комбинации. Также нейросеть позволяет гибче подходить к нормализации строк и учитывать в том числе нестандартные кейсы. При этом не обязательно подключать LLM на всех этапах генерации. Мы решили оставить алгоритмическое решение там, где оно работает хорошо. Так, этап отбора подходящих полей простой алгоритм выполняет безошибочно, поэтому мы не стали переносить его в модель.
Генерация фильтров с помощью LLM
Процесс генерации фильтров с привлечением больших языковых моделей выглядит следующим образом:
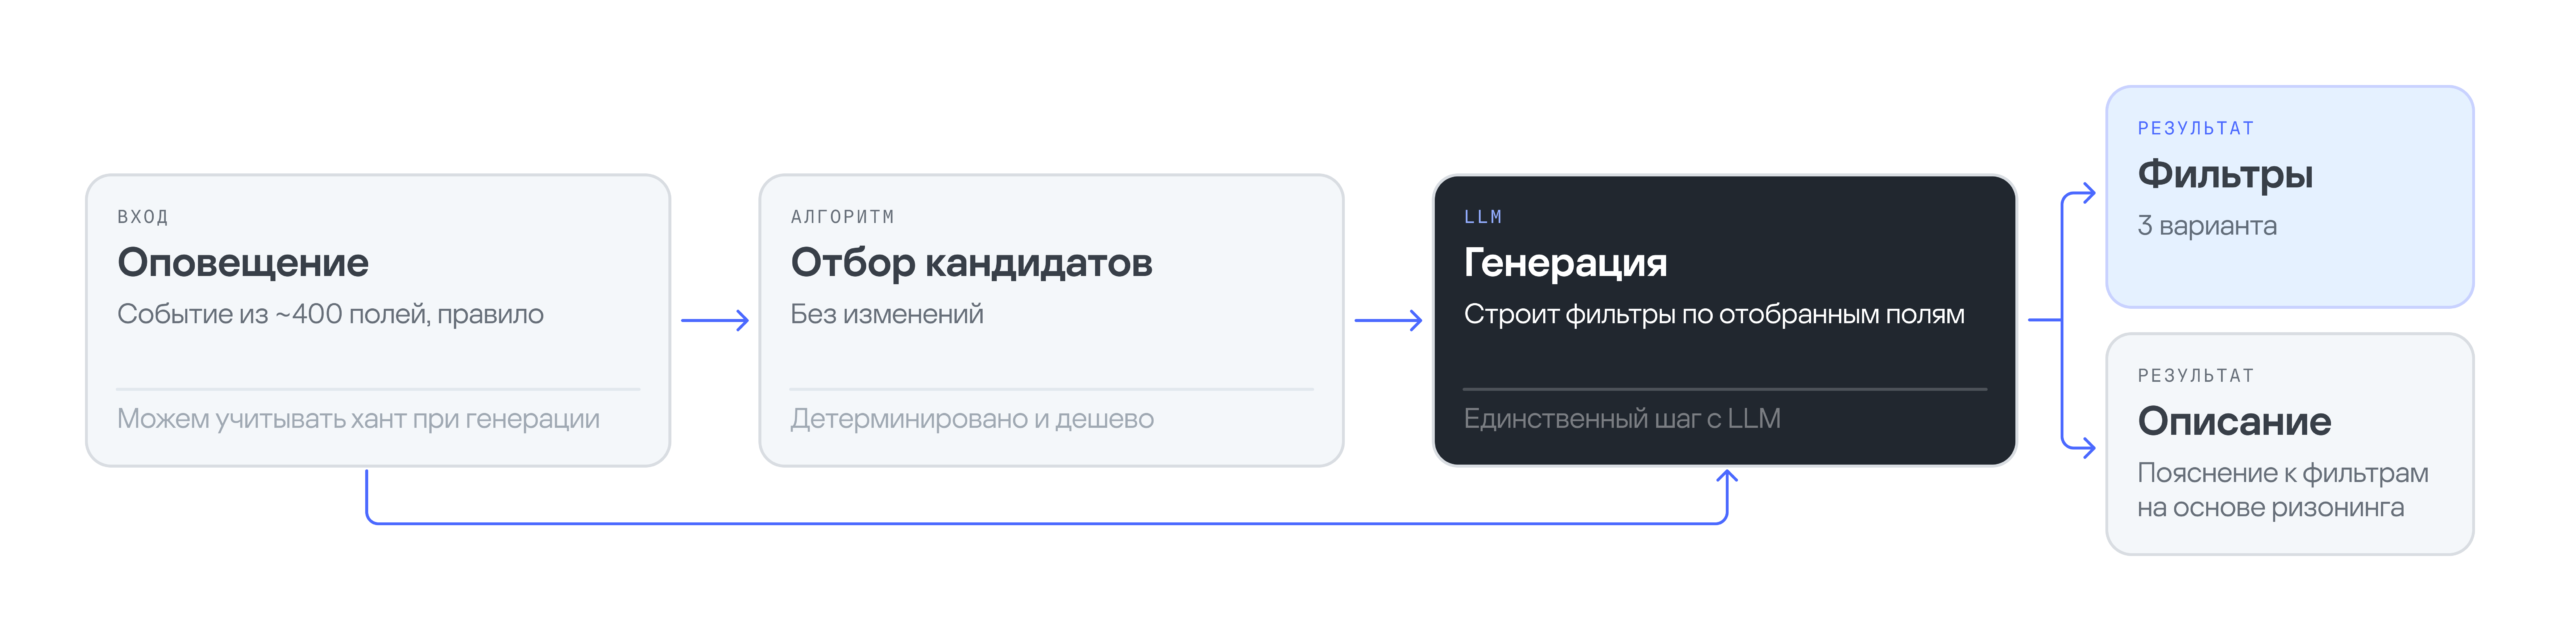
На вход по-прежнему подается оповещение, содержащее событие с 400 полями, и правило, которое на это событие сработало. Затем при помощи алгоритма отбираем наиболее подходящие поля для фильтра. Далее LLM обрабатывает входную информацию — событие, отобранные поля и детектирующее правило — и генерирует три варианта фильтра, а также пояснения к ним. Последнее помогает аналитику понять, почему предложены именно такие фильтры, и сделать обоснованный выбор.
Рассмотрим следующее событие в формате JSON:
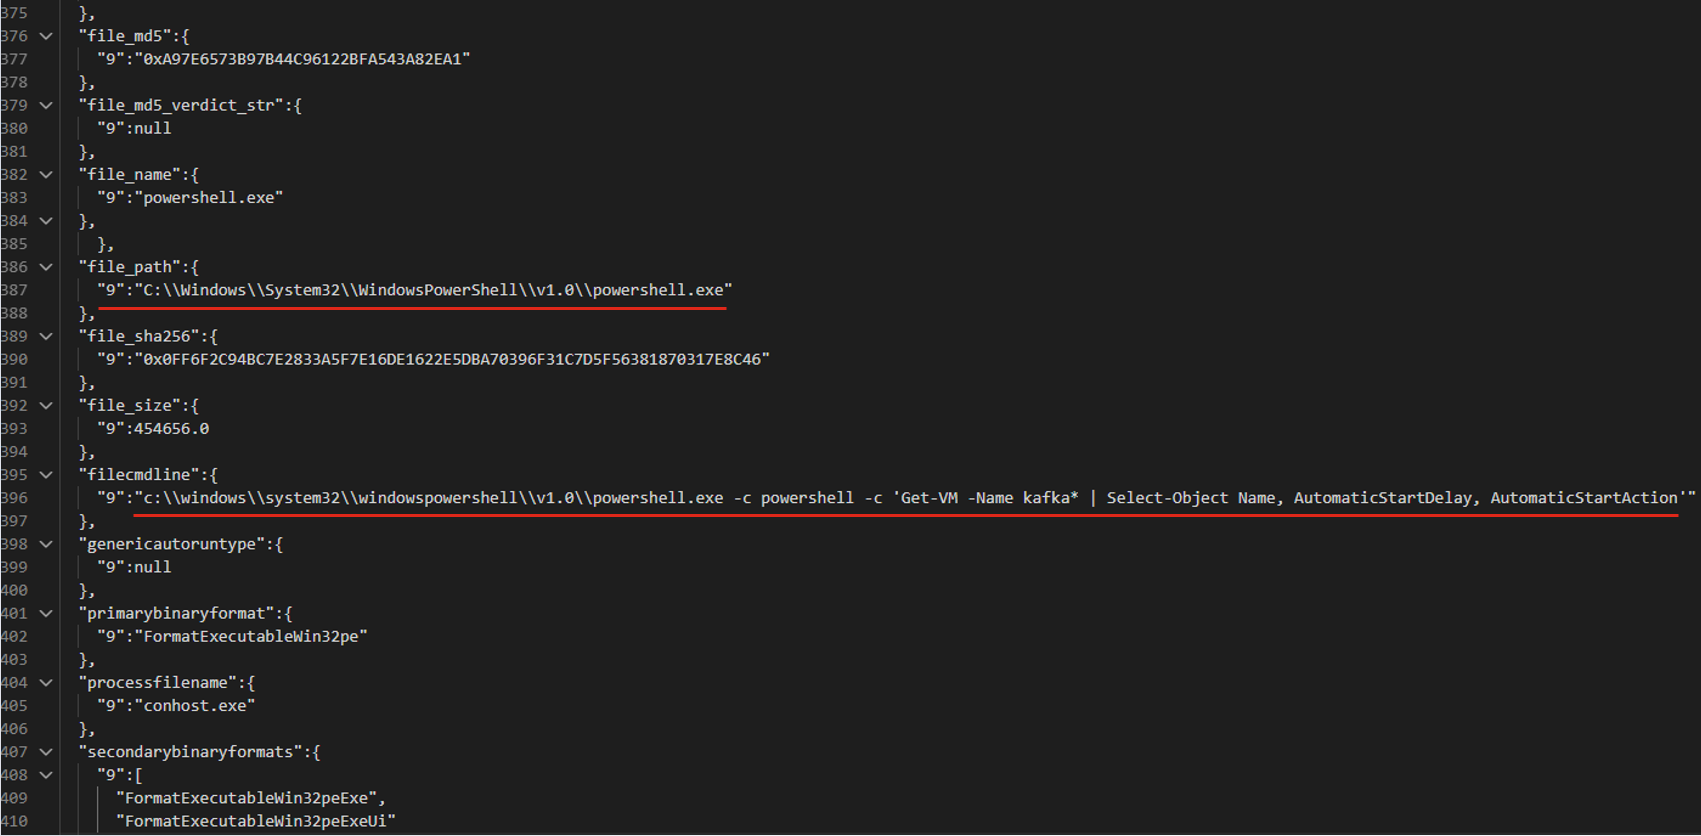
LLM предложила три варианта фильтров, содержащих общую командную строку:
-
1file_path: "\\WindowsPowerShell\\powershell.exe" AND filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "kafka*"
Как и в предыдущем примере, мы получили на выходе два валидных фильтра из трех. Последний оказался слишком широким, чтобы его можно было использовать. Аналитик выбрал для работы первый фильтр, незначительно его отредактировав:
|
1 |
file_path: "powershell.exe" AND filecmdline: "Get-VM -Name kafka\*" |
Преимущества и недостатки подхода к генерации фильтров при помощи LLM
Использование LLM решило проблемы чисто алгоритмической генерации фильтров — зависимость от контекста и ошибки при нормализации строк. Однако вариант с одним запросом к модели имел и свои недостатки. С одной стороны, в нем не была предусмотрена валидация выходных данных. LLM отдавала фильтры как есть, без проверки синтаксиса и возможности исправить ошибки. С другой — в отличие от алгоритмической версии все задачи по генерации фильтров реализованы с помощью одной системной затравки (prompt). Как следствие, незначительное исправление в одном месте может сломать логику в другом.
Использование нескольких ИИ-агентов
Чтобы решить проблемы, возникающие при использовании для генерации фильтров одной модели с одной системной затравкой, мы попробовали распределить разные задачи по разным LLM-агентам. В этой версии мы подключили агенты уже на этапе отбора релевантных полей. В общей сложности в цепочке участвуют четыре агента.
- Селектор — отбирает нужные поля.
- Генератор — генерирует фильтры.
- Валидатор — оценивает сгенерированные фильтры. Если фильтры признаны невалидными, возвращает задачу генератору. Если выбранные поля признаны нерелевантными, инициирует новый цикл отбора полей. Если фильтры прошли валидацию или же лимит попыток перегенерации исчерпан, валидные или наиболее удачные фильтры передаются аналитику.
- Комментатор — анализирует полученные на выходе фильтры и объясняет, какие значения полей использованы и почему.
Для следующего события в формате JSON агенты выдают три валидных фильтра, основанные на пути к файлу.
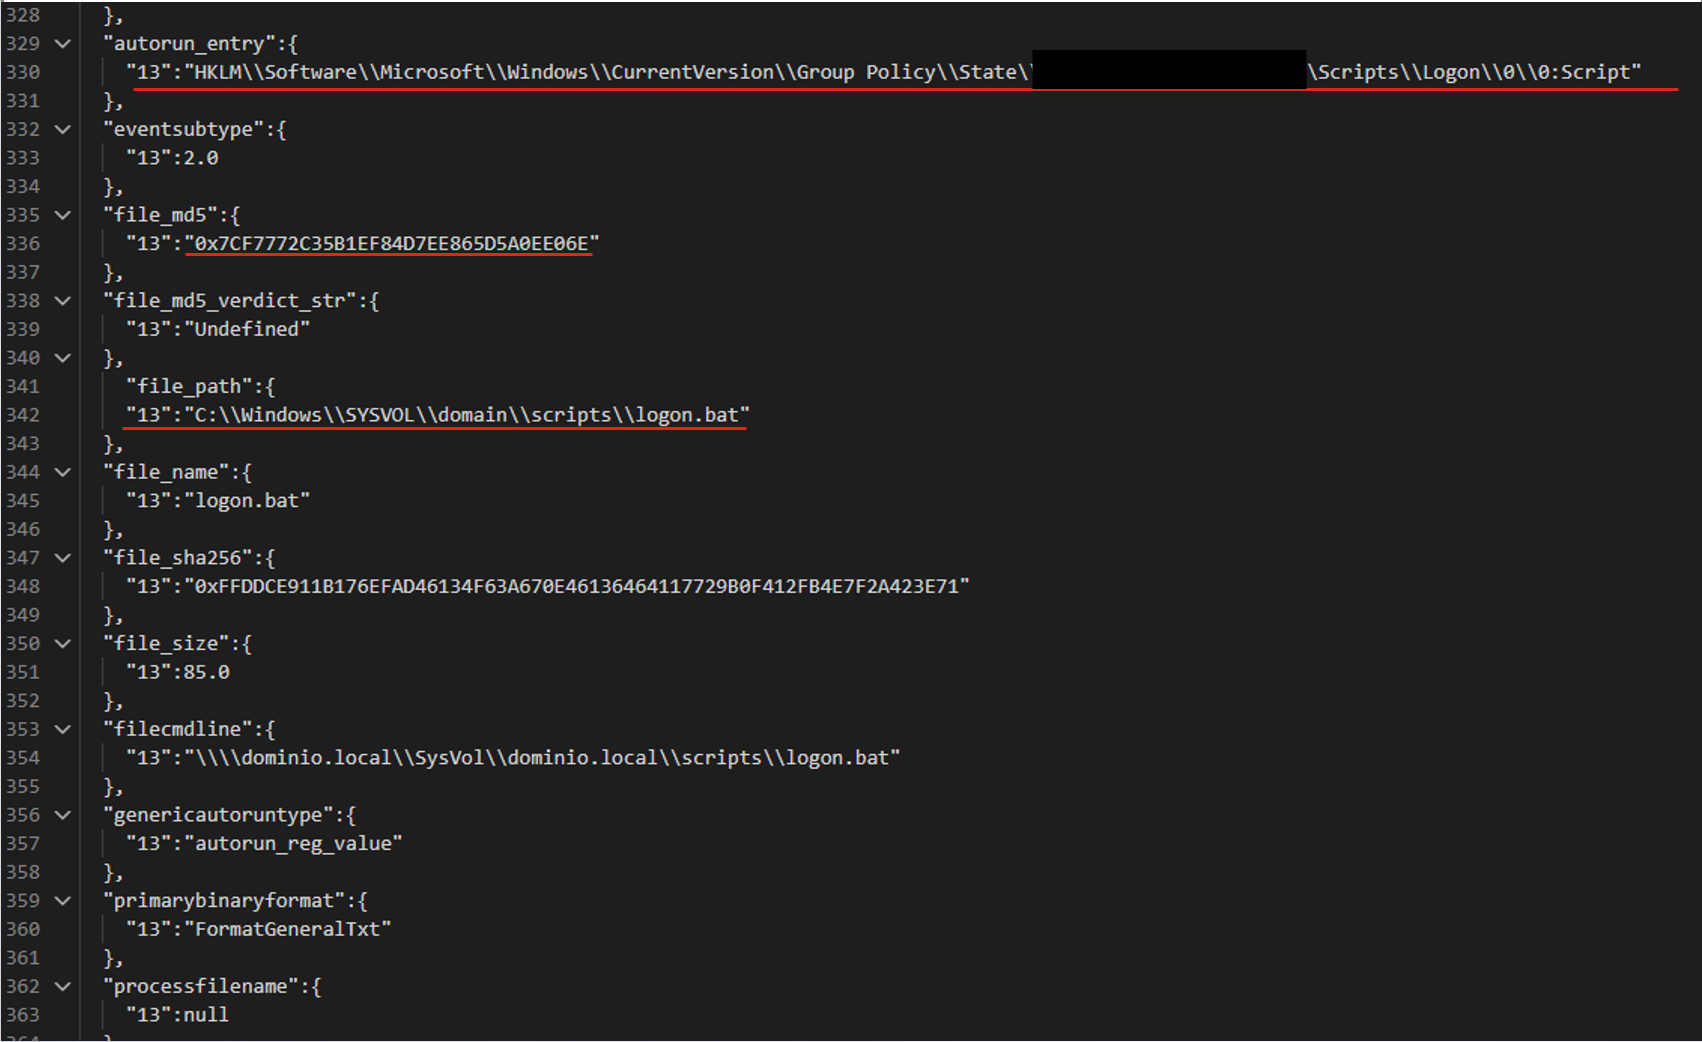
Фильтры различаются между собой дополнительными параметрами, которые подкрепляют детект:
-
1file_path:"sysvol\\domain\\scripts\\logon.bat"
-
1file_path:"sysvol\\domain\\scripts\\logon.bat" AND file_md5:"0x7..6E"
-
1autorun_entry: "Group Policy\\State" AND file_path: "SYSVOL\\domain\\scripts\\logon.bat"
Преимущества и недостатки агентного подхода
При помощи LLM-агентов мы получаем систему, способную к валидации фильтров и их коррекции, которая при этом имеет модульную архитектуру и позволяет настраивать и совершенствовать разные этапы генерации независимо друг от друга. При этом больший объем вызовов к LLM по сравнению с предыдущими подходами делает такую систему более медленной. Кроме того, она зависима от доступности модели, которой может не быть в закрытом контуре организации.
Оценка системы генерации фильтров
Чтобы оценить эффективность работы системы генерации фильтров, мы используем две основные метрики.
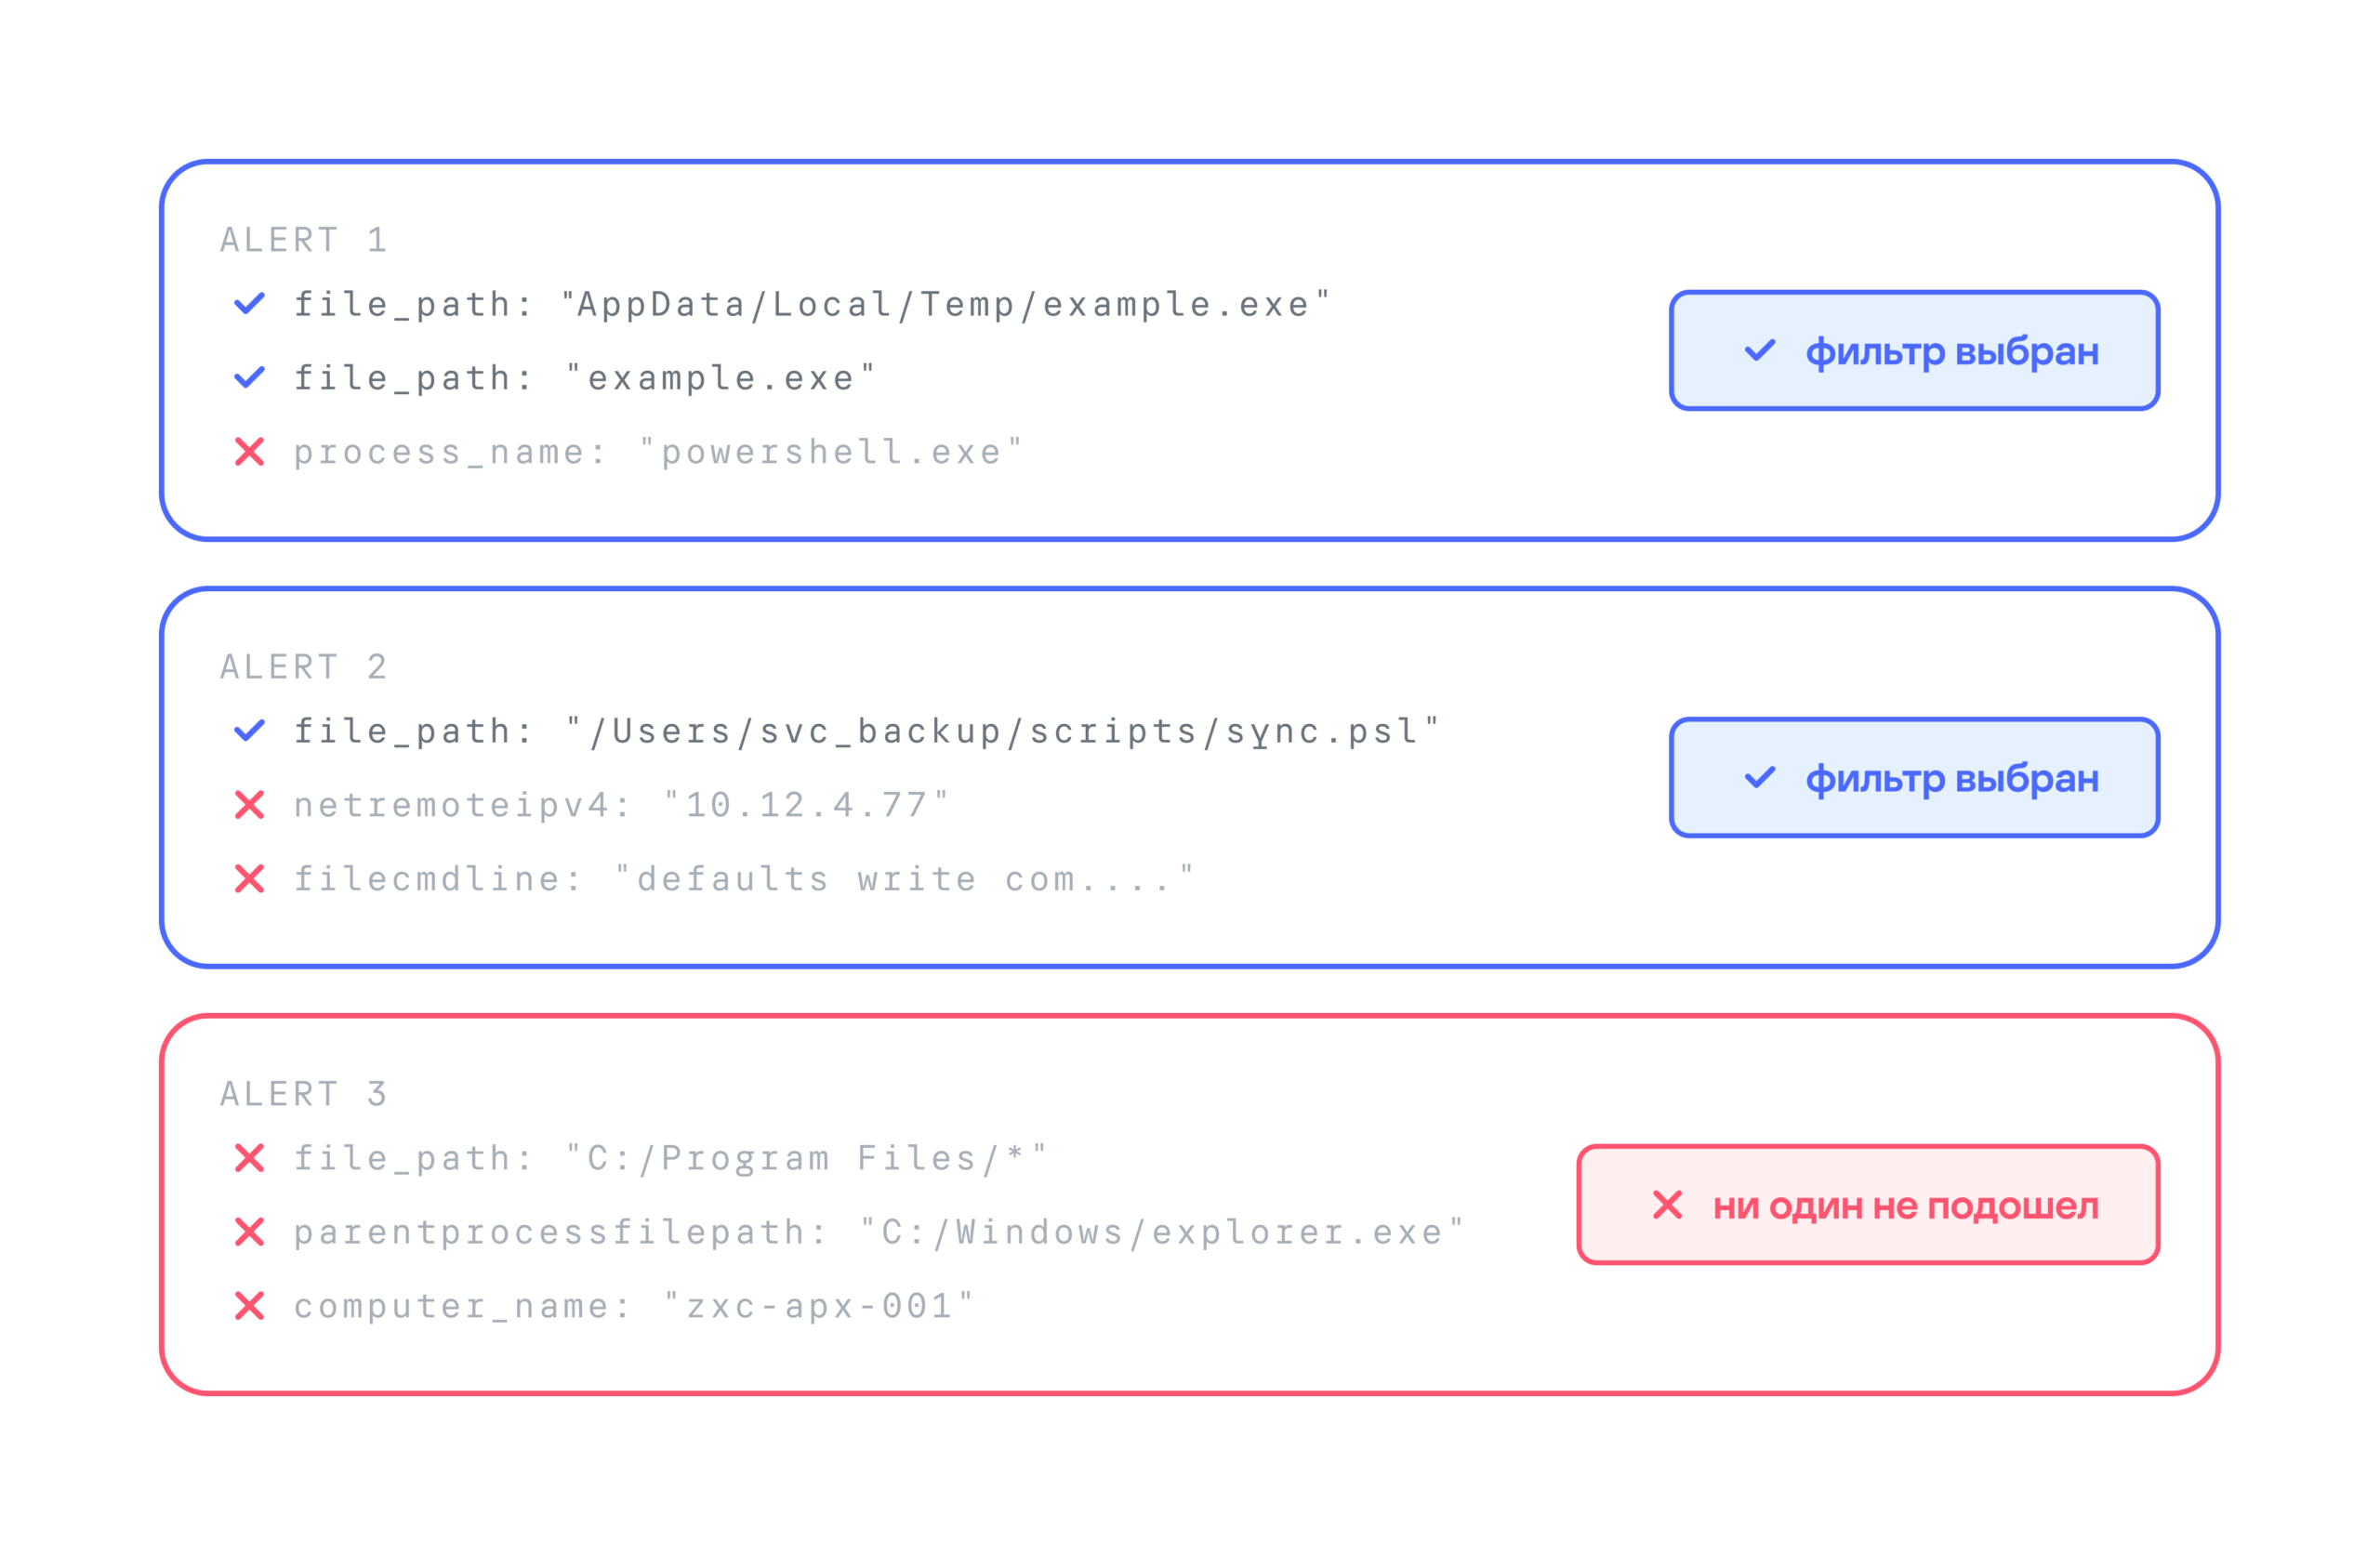
- Уровень одобрения (Approval Rate). Для каждого оповещения безопасности система предлагает три фильтра. Если аналитик выбрал хотя бы один из них —считаем генерацию успешной. Так, в примере ниже уровень одобрения = 2/3.
- Уровень снижения ложноположительных срабатываний (FP drop). Мы оцениваем, насколько фильтр помогает сократить количество ложноположительных срабатываний. Эту метрику можно оценить только по прошествии времени, поскольку необходимо сравнивать количество ложноположительных оповещений, поступивших в течение определенного времени до и после внедрения фильтра.
Ниже представлена сравнительная оценка трех систем генерации фильтров по этим метрикам.
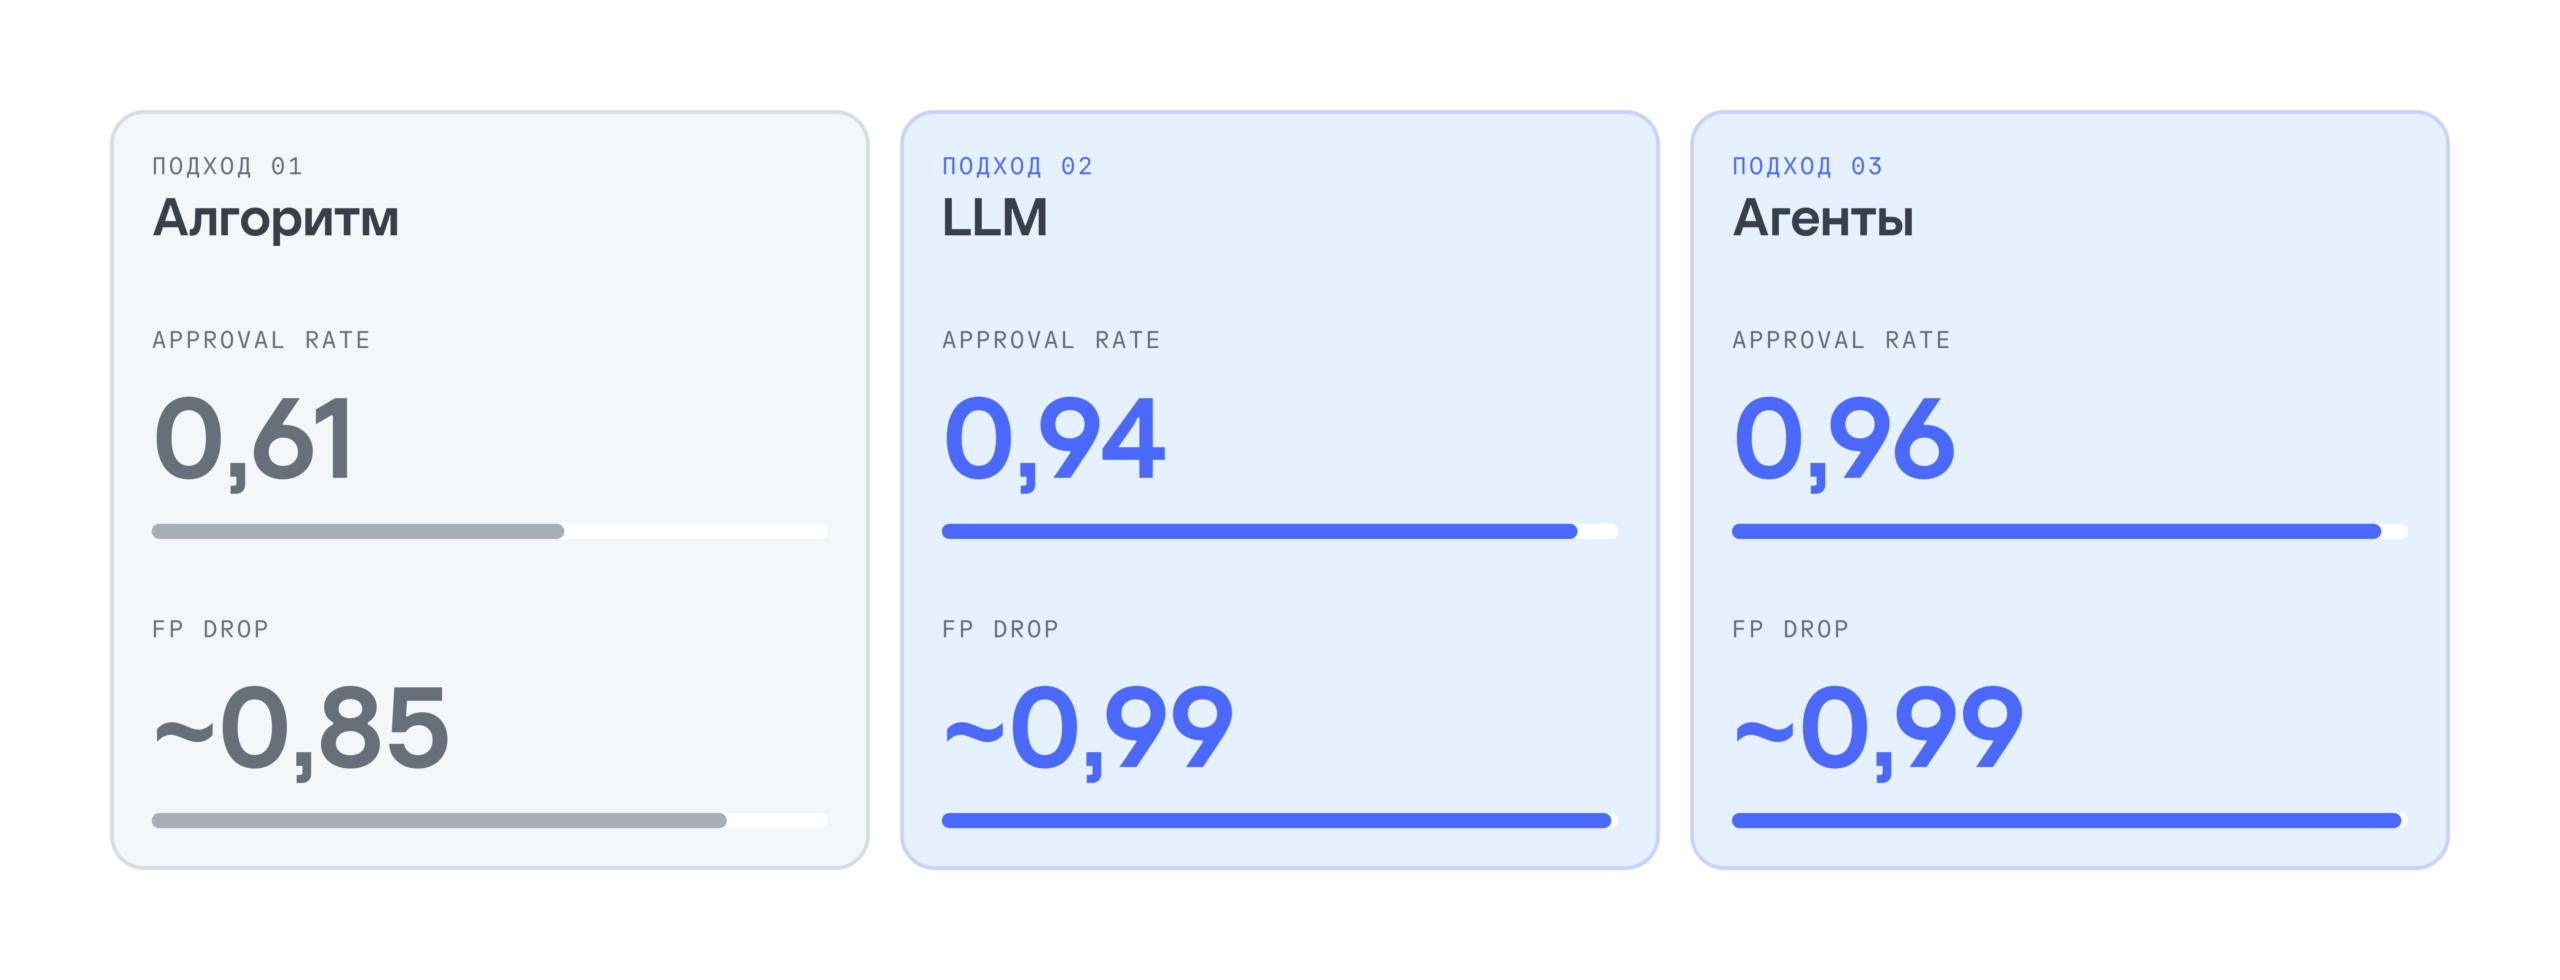
Как можно видеть, LLM значительно повышают эффективность генерации фильтров. При этом эффективность применения LLM без агентов и эффективность агентного подхода практически не различаются. Поэтому мы для себя решили остановиться на более простом и быстром варианте с применением LLM с единой системной затравкой. Как результат, мы на 99% снизили число ложноположительных срабатываний, увеличили количество генерируемых за сутки фильтров на 28% и повысили эффективность работы аналитиков с оповещениями на 17%.
Заключение
Как показала практика, генерация фильтров — задача, которая поддается эффективной автоматизации. Мы рассмотрели несколько вариантов автоматической генерации фильтров для ложноположительных оповещений безопасности: с использованием исключительно алгоритмического подхода, с помощью LLM и группы LLM-агентов. Все они способны генерировать валидные фильтры, значительно упрощая работу аналитика; при этом у каждого есть свои преимущества и недостатки.
При алгоритмическом подходе мы получили более низкие показатели метрик оценки, тем не менее в двух третях случаев он позволяет получить фильтры, которые устраивают аналитика. Особенно хороший результат такой подход дает в ситуациях, когда уже есть некий массив похожих событий, которые нужно отфильтровать (то есть накоплен достаточный контекст). При этом развернуть алгоритмический генератор можно в любой среде. Варианты на основе LLM и группы LLM-агентов показывают высокий уровень точности, при этом их результативность различается незначительно, поэтому более медленный подход с агентами на данном этапе выглядит избыточным. При наличии доступа к LLM оптимальным выглядит вариант с использованием одной модели для реализации нескольких этапов цикла генерации.


Генерация фильтров на практике: от алгоритмов к LLM